一个 70 年前的理论,如何解释 AI 工程的最新实践?
一、什么是 Harness,什么是自动控制论
1.1 Harness:AI Agent 的控制框架
在 AI 工程领域,Harness(直译”束缚”)是指围绕 AI 模型搭建的一套结构化运行框架。它不改变模型本身,而是通过设计 prompt 策略、工具调用、上下文管理、多 Agent 编排等机制,来约束和引导模型的行为,使其能够完成更复杂、更长周期的任务。
Anthropic 的工程师在实践中发现:一个设计良好的 Harness,能让 Claude 在长达数小时的自主编码任务中保持一致性;而没有 Harness 的裸模型则会频繁”跑偏”——上下文焦虑(sonnet4.5)、过早宣告任务完成、自我评价虚高等问题层出不穷。
一个有效 Harness 的核心要素:
| 要素 | 作用 |
|---|---|
| 初始化环境 | 为 Agent 提供清晰起点(任务清单、仓库状态、运行脚本) |
| 增量推进机制 | 每次只做一件事,完成后留下干净状态 |
| 状态持久化 | progress.txt + git history,让新 Agent 实例能快速接手 |
| 反馈与评估 | 独立的 Evaluator Agent 对输出进行质量评估并驱动迭代 |
1.2 自动控制论:从蒸汽机到 AI
自动控制论(Cybernetics),由数学家诺伯特·维纳(Norbert Wiener)于 1948 年在《控制论——或关于在动物和机器中控制和通信的科学》中提出。其核心研究复杂系统中的信息、控制与反馈机制。
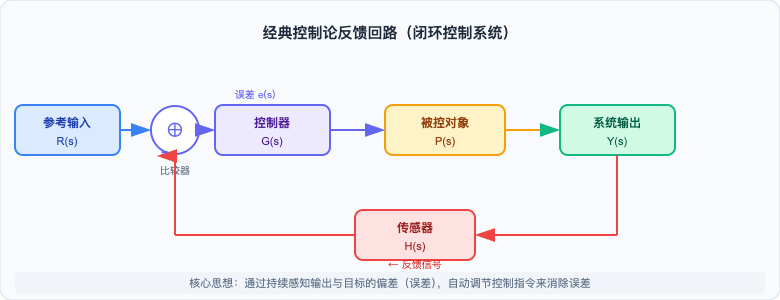
控制论的核心思想是负反馈(Negative Feedback):系统通过持续感知输出与目标之间的偏差,自动调节行为以消除误差。维纳发现这一思想具有惊人的普遍性——蒸汽机调速器、飞行员的神经-肌肉反射回路、现代计算机控制系统,在数学结构上是同一回事。
一个经典的闭环控制系统由以下部分构成:
- 参考输入 R(s):目标状态(期望值)
- 比较器 ⊕:计算期望值与实际值的偏差(误差)
- 控制器 G(s):根据误差产生控制指令
- 被控对象 P(s):接受控制指令并产生实际输出
- 传感器 H(s):感知系统实际输出
- 反馈回路:将传感器数据送回比较器,形成闭环
1.3 两者是同一种思想
我认为,Harness 与自动控制论在本质上是同一种思想在不同时代的不同表达。
把两者放在一起对照,这种同构性立刻变得显而易见:
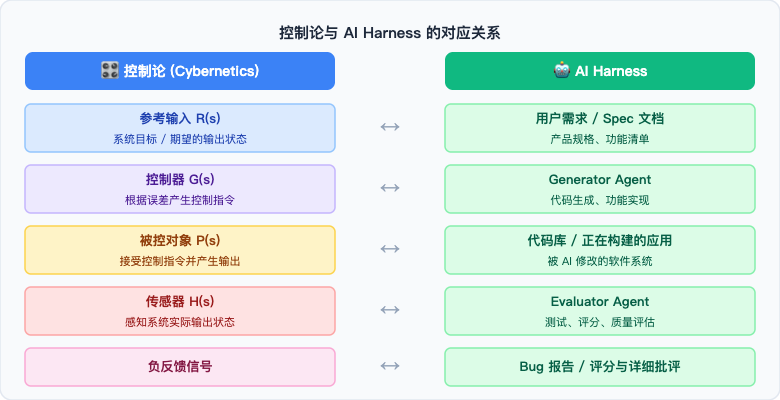
这不是比喻,也不是牵强的类比,这是严格的同构映射:维纳在 1948 年描述的那套机制,被 Anthropic 的工程师在 2025 年重新”发明”了一遍——只不过这次被控的对象是 AI 生成的代码,而不是蒸汽机的转速。
二、用自动控制论设计 Harness
2.1 开环系统的失败
没有反馈的 AI 调用,是一个开环系统:输入 prompt,产生输出,流程结束。这就像蒸汽机没有调速器——在负载稳定时或许可以工作,但稍有扰动就会失控。
Anthropic 的实践证明了这一点:让 Claude 直接执行”构建一个 2D 游戏编辑器”这样的复杂任务,不设任何反馈机制,结果是:布局浪费空间、工作流程混乱、核心游戏功能完全失效。
开环 AI 系统的四大失效模式:
- 上下文焦虑(Context Anxiety):随着 context window 填满,模型开始草草收尾,提前交工。这在早期模型(如 Sonnet 4.5)中非常严重,需要 Context Reset 来对抗;Opus 4.6 之后模型内在鲁棒性大幅提升,这一问题已基本消除。
- 过早宣告完成(Premature Completion):发现已有进展后,AI 认为任务完成并停止工作
- 自我评价虚高(Self-Evaluation Bias):AI 倾向于给自己的输出打高分,即使质量明显欠佳
- 增量失控(Incremental Drift):多轮执行后,系统状态偏离目标越来越远,且无人察觉
2.2 引入反馈:Generator-Evaluator 闭环
控制论的核心贡献是将开环系统转变为闭环系统。对应到 Harness 设计,就是为 AI 引入独立的评估机制和反馈通路。
关键洞察:分离生成者与评估者
Anthropic 的工程师发现了一个重要规律:让 AI 评估自己的工作,效果极差;但让另一个独立的 AI 来评估,配合精细调校的评估标准后,效果显著提升。
这正是控制论中传感器独立于被控对象的原则:温度传感器不是锅炉的一部分,它是独立的感知器官,为控制回路提供客观数据。
Anthropic 从生成对抗网络(GAN)中得到额外启发:让生成器和判别器相互对抗,迭代提升。这个模式在控制论中有完美的对应:
| GAN 中 | 控制论中 | Harness 中 |
|---|---|---|
| 生成器 | 控制器 G(s) | Generator Agent |
| 判别器 | 传感器 H(s) | Evaluator Agent |
| 对抗训练 | 闭环负反馈调节 | 迭代循环直至达标 |
2.3 评估标准的设计:量化主观判断
控制论中,传感器的质量决定控制质量。如果传感器测量不准,再好的控制器也无能为力。
对应到 Harness,Evaluator 的评分标准设计至关重要。以前端 UI 设计为例,”这个界面好不好看?”是无法客观评分的,但拆解为以下维度后就可以量化:
评估维度(前端设计评估器)
├── 设计质量(30%):颜色/排版/布局是否形成统一的视觉语言?
├── 原创性(30%):有无定制化决策?是否只是套用 AI 通用模板?
├── 工艺质量(20%):字体层级、间距一致性、对比度是否达标?
└── 功能性(20%):用户能否理解界面用途并完成核心任务?
调校(Calibration)的重要性: 通过提供少量高质量的示例(few-shot),将 Evaluator 的判断口味与人类偏好对齐。同时明确要求 Evaluator 保持怀疑态度,避免”宽容偏见”(AI 倾向于对 AI 的输出评价过高)。
经过调校的 Evaluator 效果显著:在全栈应用开发实验中,Evaluator 发现了诸如”矩形填充工具只在起点/终点放置 tile,而不是填充整个区域”这种具体到行号的 Bug,而非泛泛而谈”界面有些问题”。
2.4 上下文重置:控制论中的扰动恢复
控制论中有一个重要概念:鲁棒性(Robustness)——系统在受到扰动时能够恢复稳定的能力。
在 Harness 中,context window 填满就是一种系统扰动。不同的恢复策略各有权衡:
| 策略 | 控制论类比 | 优点 | 缺点 |
|---|---|---|---|
| Compaction(压缩) | 低通滤波,保留关键信息 | 保持连续性 | 上下文焦虑仍存在 |
| Context Reset(重置) | 系统复位,重新初始化 | 彻底消除焦虑 | 需精心设计状态传递 |
| Structured Handoff(结构化交接) | 状态机快照传递 | 最佳平衡 | 工程复杂度高 |
这里还验证了控制论中一个重要原则:随着被控系统能力增强,控制器的复杂度可以降低。Claude Opus 4.5 时代必须使用 Context Reset;而 Opus 4.6 内在鲁棒性增强后,部分 Harness 组件变得冗余,可以直接简化架构。
三、基于控制论的 AI Native 原生开发工具设计
3.1 AI Native 工具与传统工具的区别
传统工具是为人类设计的:IDE、构建系统、Linter 都假设人类是执行者,工具辅助人类完成工作。
AI Native 工具是为 AI Agent 设计的:工具的输出格式、错误信息、上下文结构都优化为 AI 易于解析和利用的形式。人类退后一步,成为目标设定者和监督者,而不是每行代码的执行者。
这种角色转变在控制论的框架下非常清晰:
- 传统工作流:人类 = 控制器,工具 = 执行机构
- AI Native 工作流:AI Agent = 控制器,人类 = 参考输入的设定者 + 最终验收者
3.2 四大设计原则
原则一:为反馈而生,而非为执行而生
传统工具的目标是正确执行指令。AI Native 工具的目标是提供高质量的反馈信号,让 AI 能准确感知当前状态与目标的偏差。
例如,传统 TypeScript 编译错误只需人类能读懂。AI Native 的错误报告需要:
- 精确定位问题(文件、行号、调用栈)
- 提供可能的修复方向(不仅是”什么错了”,还要有”怎么修”的线索)
- 与任务目标关联(这个错误对当前要实现的功能有什么影响?)
原则二:缩短闭环周期
控制论中,闭环频率决定系统响应速度和精度。闭环周期过长,误差在被修正前就已经积累过大。
对应到 AI Harness:每个反馈循环要足够小。Anthropic 的 Sprint 模式是典型实践——每次只实现一个功能,完成后立即由 Evaluator 评估,问题在小范围内发现和修复,不会滚雪球式累积。
原则三:状态可观测性
被控系统的状态必须对控制器可见,否则无法精准调节。AI Native 工具需要提供丰富的状态可观测性:
代码库状态可观测接口
├── git history(近期做了什么?)
├── feature_list.json(哪些功能已完成/未完成?)
├── dev server 健康状态(应用是否正常运行?)
└── 质量指标仪表板(测试覆盖率、性能分数、Lint 错误数)
原则四:人在回路的位置
在安全攸关的工业控制系统中,人类监督员的介入时机很有讲究:不能在每次微调时介入(效率极低),但必须在系统接近危险边界时介入。
AI Native 工具中,人类应该:
- ✅ 参与:设定目标、定义验收标准、在关键 checkpoint 审查
- ❌ 不参与:具体的代码实现细节、每行代码的执行过程
3.3 三层 Agent 架构
基于以上原则,一个完整的 AI Native 开发工具应具备三层 Agent 架构:
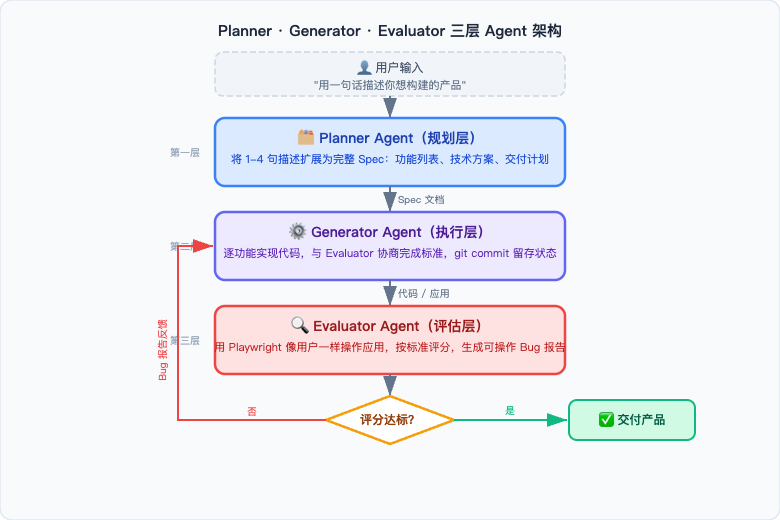
第一层:Planner Agent(规划层)
接收用户的高层意图(1-4 句话的需求描述),扩展为完整的产品规格。关键是这一层要保持高层次:只约束要交付什么(deliverables),不约束怎么实现——过度细化的技术规格一旦出错,会级联传导到后续所有环节。
第二层:Generator Agent(执行层)
按规格逐功能实现,与 Evaluator 协商”完成标准”后再开始编码,确保”做什么”的共识在”怎么做”之前达成。每个 Sprint 结束后通过 git commit 和 progress 文件记录状态,保持环境干净。
第三层:Evaluator Agent(评估层)
通过 Playwright 等工具像用户一样操作真实应用(而非静态分析代码),按既定标准评分,生成具体可操作的 Bug 报告,决定当前 Sprint 是通过还是需要返工。
这三层架构与控制论中规划器-控制器-传感器完全对应,构成了完整的闭环控制系统。
四、面向前端开发的 AI Native 工具实践
4.1 前端开发的特殊挑战
前端是最适合 AI Native 工具落地的场景之一,也是挑战最密集的场景。
核心挑战:
- 主观性强:UI/UX 质量没有绝对标准,审美因人因团队而异,AI 极易产出”安全但平庸”的界面
- 技术栈碎片化:React/Vue、CSS-in-JS/Tailwind、各种状态管理库——AI 需要感知项目的具体约束
- 设计系统约束:公司内部的 Design Token、组件库、品牌规范,限制了 AI 的自由度,但这些约束本身就是需要遵守的”参考输入”
- 跨文件一致性:组件间样式、类型、命名的一致性需要全局视角
天然优势:
- 可视化验证:Playwright 可以截图,AI 能直接”看到”渲染结果,反馈信号直观
- 快速闭环:前端 hot reload 反馈极快,闭环周期可以很短
- E2E 测试简单:模拟用户行为的测试客观性强,比单元测试更接近”真实质量”
4.2 方案一:Skill 套件(轻量化方案)
Skill 是最轻量的 AI Native 工具形式——一个精心设计的 prompt 模板,封装了某个具体技能的最佳实践和评估标准,可以直接被 AI 调用。
Anthropic 已在 Claude Code 插件中开源了 frontend-design skill,专门解决”AI 生成的前端界面千篇一律”的问题。受此启发,可以为前端团队设计一套完整的技能套件:
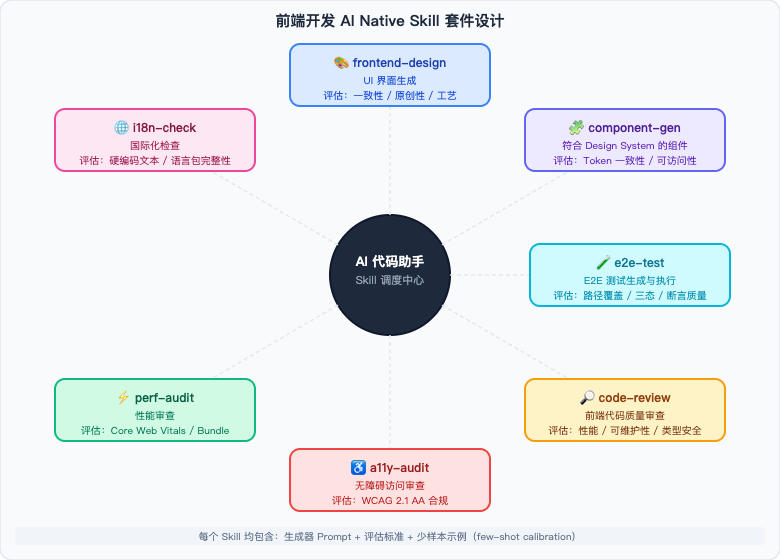
Skill 套件清单:
| Skill 名称 | 职责 | 核心评估维度 |
|---|---|---|
frontend-design | 生成高质量 UI 界面 | 设计一致性、原创性、视觉工艺、功能性 |
component-gen | 生成符合设计系统的组件 | Design Token 一致性、可访问性 |
code-review | 前端代码质量审查 | 性能、可维护性、类型安全 |
a11y-audit | 无障碍访问审查 | WCAG 2.1 AA 合规性 |
perf-audit | 性能审查 | Core Web Vitals、Bundle Size |
i18n-check | 国际化检查 | 硬编码文本检测、语言包完整性 |
e2e-test | 端到端测试用例生成与执行 | 核心路径覆盖率、三态覆盖、断言质量 |
Skill 设计的三个核心原则:
① 评估标准先行
每个 Skill 必须先定义 Evaluator 的评分维度,再设计 Generator 的输出格式。评估标准的语言会直接塑造生成内容的风格——Anthropic 发现,在标准中加入”最好的设计是博物馆级别的”这样的描述,会把输出风格引导向某种特定的视觉方向。
② 与项目约束集成
Skill 应该能主动读取项目的 .eslintrc、design-tokens.json、tsconfig.json、组件库文档等配置文件,将约束内化到自身的 context 中,而不是期望 AI 凭空感知这些约束。
③ 少样本校准(Few-Shot Calibration)
通过项目内的优秀案例作为 few-shot 示例,让 AI 的”品味”与团队对齐。这是最低成本的 Evaluator 调校手段。
示例:前端团队的 frontend-design 评分维度(适配版)
## 评估标准(4 个维度,权重合计 100%)

### 1. 设计一致性(30%)
与项目 Design System 保持一致:
- 颜色:仅使用 design-tokens.json 中定义的色板
- 间距:使用 spacing scale(4/8/12/16/24/32px)
- 字体:使用 typography scale 中定义的 size/weight/line-height

### 2. 原创性(30%)
有无针对本次需求的定制化设计决策?
- 不得使用未经修改的 stock 组件
- 不得出现 AI 通用模板特征(如紫色渐变白卡片)
- 人类设计师应能识别出明确的设计意图

### 3. 响应式适配(20%)
- Mobile-first 设计思路
- 需在 375px / 768px / 1440px 三个断点下表现正确

### 4. 交互完整性(20%)
- Loading / Error / Empty 三态全部覆盖
- 所有交互有明确的视觉反馈(hover、focus、active 状态)示例:e2e-test Skill 评分维度
## e2e-test 评估标准(3 个维度,权重合计 100%)

### 1. 核心路径覆盖(40%)
- 用户最高频的 3~5 条业务路径必须有对应测试用例
- 每条路径从入口页面到最终断言形成完整闭环
- 不得出现 `page.waitForTimeout()`(硬等待)等脆弱写法

### 2. 三态覆盖(30%)
- Success 路径:正常输入 → 成功状态
- Error 路径:网络失败 / 接口报错 → 错误状态可见且可恢复
- Empty 路径:无数据时 Empty State 正确渲染

### 3. 断言质量(30%)
- 断言语义明确,不得只断言元素存在(`toBeVisible`),需断言内容正确性
- 使用 `getByRole` / `getByLabel` 等语义选择器,禁止 CSS 类选择器
- 测试描述(`test.describe` / `it`)与断言一一对应,可读性高
e2e-test Skill 的核心价值在于它是整个控制回路的传感器端——由 Evaluator 驱动 Playwright 执行生成的测试用例,测试结果直接作为反馈信号返回 Generator,形成闭环。相比人工手写测试,Skill 生成的测试对”三态”和”断言质量”的覆盖更系统,因为这些维度已被固化在评估标准里,Generator 无法绕过。
4.3 方案二:多 Agent 协作架构(高复杂度)
对于需要端到端自动化完成的复杂前端工程任务(如”实现整个用户中心模块”),单个 Skill 调用不够,需要多 Agent 按流水线协作。与其让多个 Generator 并行、再用 Assembler 整合——这种模式在上下文冲突和接口对齐上引入了大量摩擦——不如采用任务级串行流水线:将需求拆成 N 个有序任务,每个任务走完一遍完整的质量把控,再进入下一个任务。
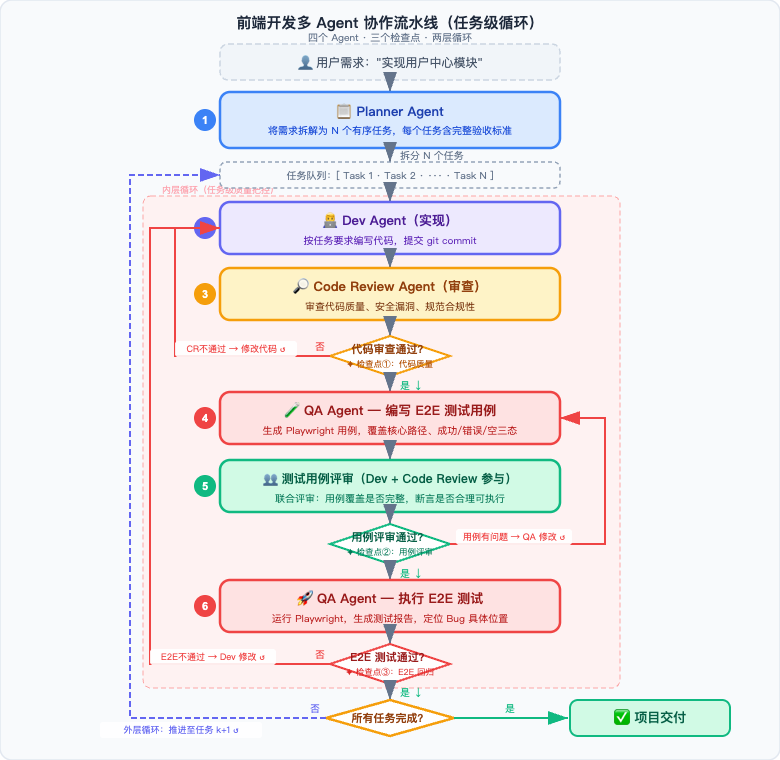
架构详解:四个 Agent,三个检查点,两层循环
第一步:Planner Agent 拆分任务
Planner 接收用户需求,产出任务队列。每个任务颗粒度控制在”一个 git commit 能完成”的范围内,并附带完整的验收标准——这是后续所有检查点的依据。
第二步:Dev Agent 实现 → Code Review Agent 审查(检查点一)
Dev Agent 针对当前任务编写代码并提交。Code Review Agent 立即对这次 commit 做审查:代码质量、安全漏洞、规范合规性。不通过则打回 Dev Agent 修改,合格后才进入下一阶段——这保证了每一段代码在被测试之前已经过人工级别的静态审查。
第三步:QA Agent 编写用例 → Dev + CR 联合评审(检查点二)
代码通过 Code Review 之后,QA Agent 根据任务验收标准生成 Playwright E2E 测试用例。关键在于:测试用例在执行之前,要先经过 Dev Agent 和 Code Review Agent 的联合评审。
这一步解决了一个常被忽视的问题:测试用例本身也可能写错——断言逻辑有误、场景遗漏、误判边界。联合评审让 Dev Agent(最了解实现细节)和 Code Review Agent(最了解代码规范)在测试执行之前就纠正用例偏差,避免”测了一遍发现测的不对”的浪费。评审通过,用例锁定;不通过,QA Agent 修改后重新提交评审,循环至用例无异议。
第四步:QA Agent 执行测试(检查点三)
用例经审批后,QA Agent 执行 Playwright 测试。测试报告精确定位 Bug 所在——哪行代码、哪个断言、什么错误信息。不通过则反馈给 Dev Agent,Dev Agent 修改代码后重走 Code Review → QA 执行循环,直至测试全部通过。
外层循环:任务完成后进入下一任务
当前任务通过所有检查点后,流水线推进到任务队列的下一个任务,Dev Agent 开始实现下一段功能。如此循环,直到 N 个任务全部完成,项目交付。
4.4 渐进式落地建议
对于大多数前端团队,建议渐进演进,而非一步到位:
阶段一(1-2 周):引入 Skill
  → 配置 frontend-design skill + 团队设计规范
  → 在非关键页面试用,收集反馈,校准评分标准
  → 目标:AI 生成的界面不再"千篇一律"

阶段二(2-4 周):建立自动化 Evaluator
  → 搭建 ESLint + Playwright + Lighthouse 自动评估链路
  → 让 AI 能自主运行这些工具并解读结果
  → 目标:引入反馈闭环,AI 能自我纠错

阶段三(1-2 月):编排多 Agent
  → 加入 Planner Agent 做需求分解,任务级串行流水线
  → Code Review Agent + QA Agent 形成三个检查点
  → 逐步扩大自动化覆盖范围
  → 目标:从"辅助编码"升级为"端到端功能交付"
结语
维纳在 1948 年写道:“信息是控制的灵魂。”
70 年后,当我们在 AI 工程领域重新发现反馈、闭环、状态可观测性的价值时,才意识到他看到的是多么普遍的规律。
Harness 不是 AI 时代的新发明,它是控制论思想在 AI 工程场景下的自然延伸。当我们设计一个 AI Native 的前端开发工具时,本质上是在为一个新型的”被控对象”(AI Agent + 代码库)设计控制系统:参考输入 R(s)用户需求→控制器 G(s)Generator→被控对象 P(s)代码库→传感器 H(s)Evaluator→负反馈反馈
理解这个映射,就理解了设计 Harness 的本质。
工具会变,模型会迭代,但反馈闭环的底层逻辑不会变。下次当你在调试一个 AI Agent 为什么总是”跑偏”时,不妨问自己:这个系统的传感器在哪里?反馈通路是否通畅?